
Context engineering : ce qui manque à votre agent IA
Un agent IA vaut ce que vaut son contexte, où manque presque toujours la parole des utilisateurs. Nous montrons comment la collecter et la brancher.
14 octobre 2026
Godefroy
- En context engineering, les équipes soignent la documentation, les outils et la mémoire de l’agent IA. Elles oublient pourtant presque toujours ce que les utilisateurs disent de leur problème, avec leurs mots.
- Les analytics montrent ce que font les gens et les tickets montrent ce qui casse. Pour savoir pourquoi, il faut parler aux gens. Un agent privé de ces conversations invente le pourquoi.
- Une interview vocale asynchrone collecte la parole des utilisateurs sans équipe de recherche : un lien par personne, une IA qui relance, un transcript que l’agent lit par API ou en MCP.
- Mettez dans le prompt une fiche courte, datée et sourcée, plutôt que cinquante transcripts bruts. Un contexte trop long dégrade aussi les réponses de l’agent.
- Une douzaine d’interviews indique une direction, que vos analytics doivent ensuite chiffrer. Datez chaque constat et relancez la même interview chaque trimestre.
Un agent IA ne fait jamais mieux que le contexte qu’on lui donne. Le context engineering consiste à choisir ce contexte : le prompt, les documents, les outils, la mémoire. La plupart des équipes y mettent leur documentation et leurs données, puis s’arrêtent là. Il manque alors ce que les utilisateurs disent de leur problème : leurs raisons, et les mots qu’ils emploient. Vous pouvez les collecter sans équipe de recherche, avec des interviews vocales menées par une IA, puis les brancher sur l’agent par API REST ou par serveur MCP, sous la forme d’une fiche courte et datée. Nous détaillons une chaîne n8n complète, puis les limites de la méthode.
Le context engineering, et sa pièce manquante
L’expression a pris en juin 2025. Tobi Lütke, le PDG de Shopify, a dit la préférer à « prompt engineering », et Andrej Karpathy, chercheur en IA et cofondateur d’OpenAI, a renchéri en la définissant comme « l’art délicat et la science de remplir la fenêtre de contexte avec exactement la bonne information pour l’étape suivante ». Anthropic a ensuite publié ses conseils de context engineering pour les agents, en insistant sur un point que les équipes découvrent à leurs dépens : un modèle retrouve moins bien l’information à mesure que son contexte s’allonge, donc on ne peut pas tout y verser.
Le sujet compte parce que les agents déçoivent surtout par leurs réponses. Dans l’enquête State of Agent Engineering de LangChain, menée fin 2025 auprès de 1 340 professionnels, 57 % ont déjà des agents en production, mais la qualité des réponses reste le premier frein cité (32 %), alors que le coût inquiète moins qu’avant. Gartner prévoit de son côté que plus de 40 % des projets d’IA agentique seront abandonnés d’ici fin 2027, entre des coûts qui grimpent et une valeur métier floue. Un agent qui produit une réponse juste mais à côté du besoin tombe exactement dans ces deux cases.
Les sources de contexte d’un agent IA et leurs angles morts
Un agent en entreprise puise d’ordinaire dans quatre sources, et peut en avoir une cinquième : ce que disent ses utilisateurs. Chacune a un angle mort.
| Source de contexte | Son apport | Son angle mort |
|---|---|---|
| Prompt système et règles | Le ton, les interdits, la marche à suivre | L’écart entre ces règles et les attentes des gens |
| Documentation et base de connaissances | Les fonctions du produit et leur fonctionnement | Les malentendus des utilisateurs |
| Analytics produit | Les actions des gens, l’étape où ils décrochent | La raison du décrochage |
| Tickets de support et CRM | Les pannes, qui a acheté quoi | L’avis de ceux qui partent sans se plaindre |
| La parole des utilisateurs | Leurs raisons, leurs mots, les solutions essayées avant | Une mesure : une douzaine de personnes ne fait pas une statistique |
Le prompt, la documentation, les analytics et les tickets décrivent le produit et les comportements. Aucune de ces sources ne contient les raisons. Imaginez un agent qui priorise un backlog. Il voit que 30 % des comptes n’activent jamais l’intégration Slack, mais il ne sait pas si c’est parce qu’ils n’en voient pas l’intérêt, parce que leur admin bloque les applications tierces, ou parce qu’ils ne l’ont jamais trouvée. Il va quand même choisir une explication. Dans le meilleur cas, il choisit celle qui revient le plus souvent dans sa documentation. Dans le pire, il l’invente avec aplomb.
Les mots comptent autant que les raisons. Un agent qui rédige une page d’accueil ou un email d’onboarding écrit « centralisez vos workflows » parce que c’est le vocabulaire de la documentation interne. Vos clients, eux, disent « arrêter de recopier les commandes à la main ». Sans leurs phrases dans le contexte, l’agent reproduit le jargon de l’équipe.
graph TD
    P[Prompt système et règles] --> A[Agent IA]
    D[Documentation] --> A
    N[Analytics produit] --> A
    T[Tickets et CRM] --> A
    U[Ce que disent les utilisateurs<br/>raisons, mots, alternatives essayées] -.->|souvent absent| A
    A --> R[Réponse, décision, texte]
Les agents qui ont le plus besoin de signal terrain
Tous les agents n’ont pas besoin d’entendre leurs utilisateurs. Un agent qui rapproche des factures d’un grand livre peut vérifier son travail sur les chiffres eux-mêmes, donc l’avis des comptables ne changera rien au rapprochement. Le manque se fait sentir dès que l’agent produit quelque chose qu’une personne doit trouver utile, convaincant ou clair :
- l’agent de priorisation produit, qui classe des demandes sans savoir lesquelles bloquent vraiment les gens,
- l’agent de rédaction marketing, qui a besoin des objections et du vocabulaire des clients,
- l’agent de support, dont les réponses sont exactes mais passent parfois à côté de la question posée,
- l’agent d’onboarding, qui doit savoir où les nouveaux comptes se perdent et ce qu’ils cherchaient en s’inscrivant,
- l’agent de qualification commerciale, qui doit reconnaître le problème d’un prospect avec ses propres mots.
Pour ces agents, ce que disent les utilisateurs entre dans le contexte avant l’exécution, pour que l’agent parte du bon endroit. Le retour récolté après coup sur une réponse précise sert à autre chose : corriger une erreur déjà faite. Cette boucle de correction relève du human in the loop appliqué aux agents.
Collecter du signal terrain sans équipe de recherche
La méthode existe depuis longtemps : on parle aux gens. Ce qui bloque une équipe produit, c’est le coût. Trouver un créneau, mener l’appel, prendre des notes, transcrire : dix interviews prennent une semaine de travail à quelqu’un, donc elles se font au lancement et rarement ensuite.
Nous avons construit Raconte pour faire ce travail à la place de l’équipe. Vous décrivez l’interview dans un prompt, chaque personne reçoit un lien, parle quand elle a un moment, et une IA mène la conversation à la voix en relançant comme le ferait un intervieweur. Sur Raconte, 82 % des personnes invitées vont jusqu’au bout de leur interview, qui dure 16 minutes en moyenne. Vous récupérez pour chaque interview le transcript, l’audio, un résumé et le sentiment de chaque réponse.
La voix compte ici pour une raison pratique : on tape autour de 40 mots par minute et on parle autour de 150, donc un champ libre de formulaire récolte deux phrases, là où une conversation apporte des exemples, des hésitations et des détours. Ces détours contiennent souvent ce qu’un agent ne trouvera nulle part ailleurs.
Trois réglages rendent une interview utile à un agent :
- Posez une seule question de fond par interview (« pourquoi avez-vous arrêté d’utiliser l’intégration Slack ? »), avec deux ou trois relances prévues dans le prompt.
- Demandez des faits passés plutôt que des intentions, comme le recommande Rob Fitzpatrick, entrepreneur et auteur de The Mom Test : « racontez la dernière fois que » donne de la matière, alors qu’à « est-ce que vous utiliseriez », les gens répondent par politesse. Vous pouvez construire votre guide d’entretien question par question.
- Terminez toujours sur une question ouverte (« y a-t-il quelque chose que je ne vous ai pas demandé ? »), parce que les réponses que ni vous ni l’agent n’aviez prévues arrivent souvent à ce moment-là.
Brancher Raconte sur un agent : API REST, MCP et webhooks
On branche Raconte sur un agent de trois façons. Le choix dépend de qui pilote : un assistant IA qui raisonne, ou un workflow que vous avez câblé.
| Surface | Qui l’appelle | Usage typique |
|---|---|---|
| Serveur MCP | Un assistant ou un agent (Claude, Cursor, un agent n8n) | L’agent décide lui-même de créer une interview, d’inviter des gens et de relire les transcripts |
| API REST | Votre backend ou un nœud HTTP | Un workflow déterministe qui crée des interviews et invite des listes de personnes |
| Webhooks | Raconte, vers votre endpoint | Être prévenu à la fin de chaque interview, avec le transcript dans le payload |
Le serveur MCP répond sur https://api.raconte.ai/api/mcp et expose huit outils, quatre sur les interviews et quatre sur les invitations. Un agent peut par exemple appeler create-interview avec un prompt et une liste d’invités, puis get-interview pour relire les transcripts et les résumés. La configuration du serveur MCP varie d’un client à l’autre. Pour chaque outil, vous trouverez aussi des exemples de demandes à formuler à l’agent.
L’API REST répond sur https://api.raconte.ai/v1, avec une clé d’API d’organisation en header bearer et un quota de 300 requêtes par minute. Trois routes suffisent pour la plupart des chaînes :
POST /v1/interviewscrée l’interview à partir d’un prompt.POST /v1/interviews/{id}/invitations/bulkcrée et envoie une invitation par personne.GET /v1/invitations/{invitationId}renvoie le transcript complet, le résumé et le sentiment par réponse.
Le webhook interview.completed part quand une personne termine son interview. Il attend la fin de l’analyse pour inclure le résumé et le transcript complet, chaque réponse portant un sentiment (positive, neutral ou negative). Son payload contient donc déjà de quoi alimenter l’agent, sans autre appel.
Raconte ne produit pas de rapport agrégé sur plusieurs interviews. L’agent les compare lui-même en lisant les transcripts, ce qui est justement le travail qu’on lui demande.
Exemple : une chaîne n8n de bout en bout
Prenons un SaaS B2B dont l’agent d’onboarding envoie des emails aux nouveaux comptes. L’équipe veut qu’il sache pourquoi certains comptes n’activent jamais le produit, et avec quels mots ils le disent. L’essentiel de la chaîne tient dans deux workflows n8n.
Le premier workflow invite les personnes :
- Un nœud Schedule Trigger se déclenche chaque lundi à 9 h.
- Un nœud HTTP Request interroge votre base ou votre CRM pour lister les comptes inscrits il y a quatorze jours qui n’ont pas activé l’intégration principale.
- Un second nœud HTTP Request appelle
POST /v1/interviews/{id}/invitations/bulksur une interview créée une fois pour toutes, avec le nom et l’email de chaque personne.
On crée cette interview avec un prompt de ce genre :
{ "title": "Comptes non activés à J+14", "locale": "fr", "prompt": "Tu interroges une personne qui a créé un compte il y a deux semaines sans connecter son outil principal. Demande-lui ce qu’elle cherchait en s’inscrivant, puis raconte avec elle la dernière fois qu’elle a ouvert le produit : ce qu’elle a essayé, où elle s’est arrêtée, ce qu’elle a fait à la place. Fais-lui décrire son problème avec ses mots. Termine en lui demandant s’il y a autre chose qu’on aurait dû lui demander."}Le second workflow transforme chaque interview en contexte :
- Un nœud Webhook reçoit
interview.completed. Répondez tout de suite avec un 200 : Raconte coupe la requête après 5 secondes et ne réessaie pas. - Un nœud Code vérifie la signature HMAC (
x-raconte-signature) avec votre secret. - Un nœud AI Agent lit le transcript et en extrait un constat, la citation qui l’appuie, et le segment du compte.
- Le constat s’ajoute à une fiche de contexte (une page Notion, un document Google ou un fichier Markdown dans un dépôt), que l’agent d’onboarding charge dans son prompt.
Un troisième déclencheur, mensuel, demande à un agent de relire la fiche entière, de fusionner les constats qui se répètent et de proposer des changements au prompt de l’agent d’onboarding. Une personne valide ces changements avant qu’ils s’appliquent.
graph TD
    S[Schedule Trigger, chaque lundi] --> Q[HTTP Request : comptes non activés à J+14]
    Q --> I[HTTP Request : POST invitations/bulk]
    I --> R[Raconte mène les interviews à la voix]
    R -->|interview.completed| W[Webhook n8n et vérification de signature]
    W --> X[AI Agent : constat, citation, segment]
    X --> F[Fiche de contexte datée]
    F --> O[Agent d’onboarding : son prompt charge la fiche]
    F --> M[Revue mensuelle : un humain valide les changements de prompt]
    M --> O
Comme le webhook ne réessaie pas, ajoutez un rattrapage quotidien : GET /v1/interviews/{id}/invitations liste les invitations avec leur statut, et le workflow traite celles qui sont terminées mais absentes de la fiche. Si vous préférez qu’un agent pilote tout sans workflow figé, le nœud MCP Client Tool de n8n branche le serveur MCP de Raconte directement sur un nœud AI Agent.
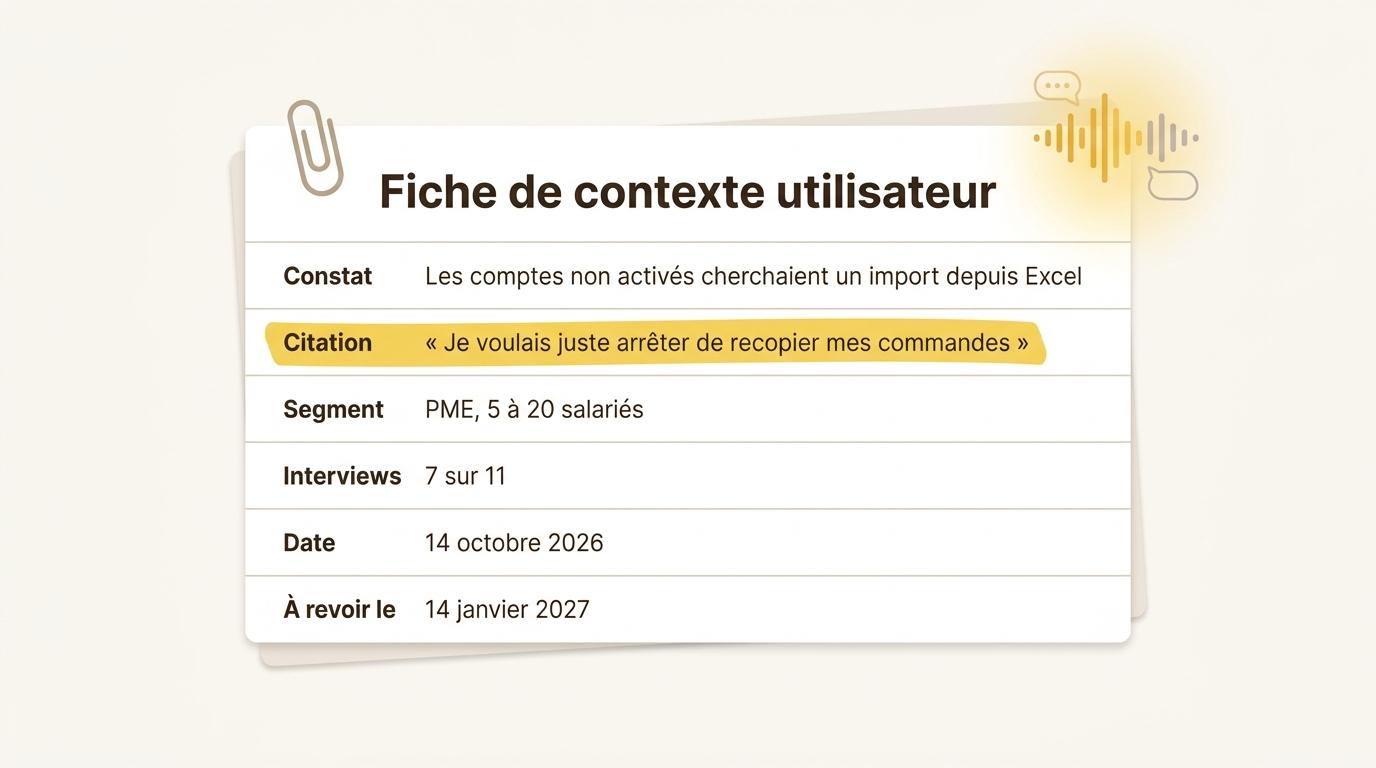
La fiche de contexte compte plus que les transcripts dans cette chaîne. Chaque ligne y porte une date et une source. Elle reste courte, puisque l’agent la lit en entier à chaque exécution.
Les limites : échantillon, biais et fraîcheur
Un agent nourri de ce que disent les utilisateurs se trompe moins, mais il peut se tromper avec plus d’assurance. Nous voyons cinq limites. La plupart méritent une ligne dans le prompt de l’agent lui-même.
Une douzaine d’interviews donne une direction. Elle ne donne pas une proportion. Si sept personnes sur onze parlent de l’import Excel, l’agent peut en conclure que c’est un blocage fréquent dans ce segment, pas que 64 % des clients le vivent. Gardez le nombre d’interviews à côté de chaque constat, et vérifiez la fréquence avec vos analytics.
Les gens qui répondent ne représentent pas tout le monde. Ceux qui acceptent de parler sont souvent les plus engagés ou les plus agacés. Invitez par segment plutôt qu’en masse, et notez quels segments n’ont pas répondu : un trou dans la fiche est une information.
Le prompt de l’interview porte les biais de celui qui l’écrit. Un agent qui rédige lui-même ses questions demandera ce qu’il croit déjà important. Faites relire le prompt par une personne avant l’envoi, et gardez la question ouverte de fin.
Un résumé perd des choses. Servez-vous du résumé de chaque interview pour trier, puis de la citation exacte pour décider. Mettez au moins une citation par constat dans la fiche, et gardez le lien vers le transcript pour qu’une personne puisse vérifier. Le sentiment par réponse aide à repérer les passages tendus, mais il ne remplace pas la lecture.
Un constat vieillit. Ce que les comptes non activés disaient en mars ne vaut plus forcément après une refonte de l’onboarding en juin. Datez chaque ligne, donnez-lui une date de révision, et relancez la même interview chaque trimestre. Retirez de la fiche ce que personne n’a redit depuis deux trimestres. Un contexte trop long dégrade aussi la réponse, comme le rappelle Anthropic, donc une fiche qui ne fait que grossir finit par nuire à l’agent qu’elle devait aider.
Il faut aussi penser aux données personnelles. Prévenez les gens que leur interview sert à améliorer le produit, et retirez noms et emails avant de verser une citation dans un contexte que d’autres outils liront.
Par où commencer
Choisissez l’agent dont les réponses sonnent juste mais tombent à côté, et la question à laquelle il répond aujourd’hui en devinant. Écrivez une interview autour de cette question, invitez dix personnes du segment concerné, et faites tenir ce qu’elles disent dans une fiche d’une page que l’agent charge à chaque exécution. Comparez ses réponses avant et après.
Les 60 minutes d’interview offertes chaque mois, sans carte bancaire, couvrent au moins trois interviews de durée moyenne. Au-delà, la minute d’interview active coûte 0,10 €. Créez un compte sur Raconte, générez une clé d’API, et votre agent peut lancer sa première interview à sa prochaine exécution.


